요즘은 API 키 하나로 LLM 서비스를 만들 수 있습니다.
그런데 vLLM 설정을 만지다 KV 캐시라는 말이 나오고,
파인튜닝 문서를 열면 LoRA, MoE, 플래시 어텐션이 쏟아지면
이게 정확히 무슨 일을 하는지 막히는 순간이 옵니다.
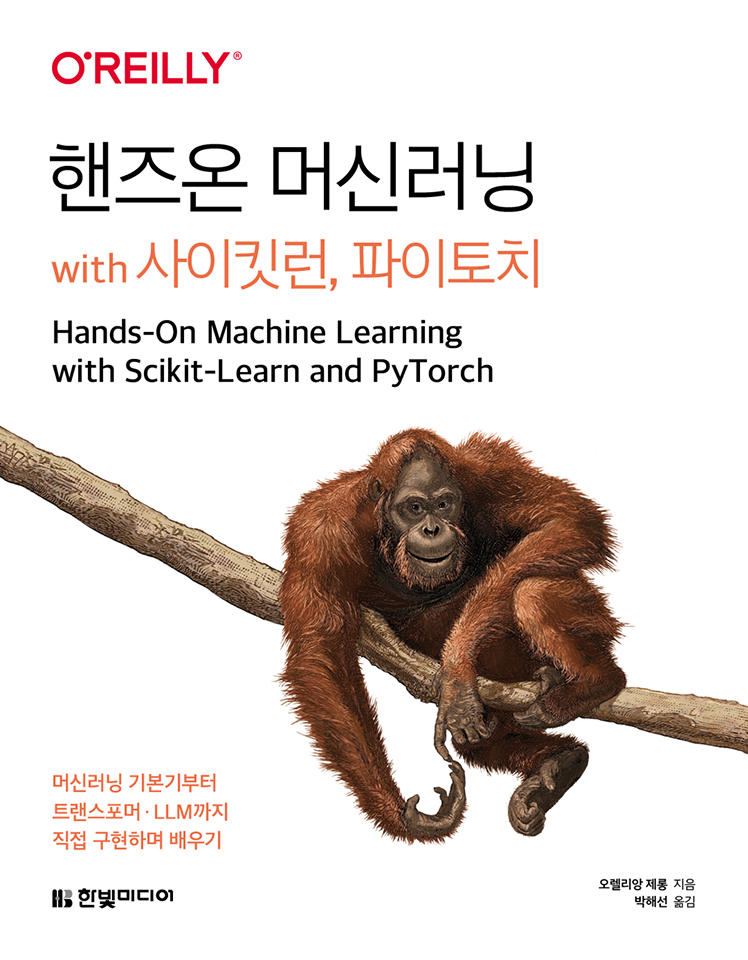
오늘 소개할 책은 한빛미디어의 "핸즈온 머신러닝 with 사이킷런, 파이토치" 입니다.
주황색 원숭이 표지로 유명한 <핸즈온 머신러닝> 시리즈가
이번에는 텐서플로 대신 파이토치로 새로 쓰였습니다.
부제도 "머신러닝 기본기부터 트랜스포머·LLM까지 직접 구현하며 배우기"입니다.
한눈에 보기
저자 / 역자 : 오렐리앙 제롱 / 박해선
출간 : 2026년 9월, 1,112쪽, 난이도 초중급
구성 : 1부 머신러닝(사이킷런) 8장, 2부 신경망과 딥러닝(파이토치) 11장, 부록 5개
실습 : 주피터 노트북 제공, 구글 코랩에서 바로 실행
이런 분께 : LLM을 써 봤지만 내부가 궁금한 개발자, 텐서플로에서 파이토치로 넘어가는 분
한 줄 평 : 선형 회귀부터 KV 캐시, MoE까지 한 권으로 이어지는 머신러닝 지도
3판을 읽었다면, 무엇이 달라졌을까
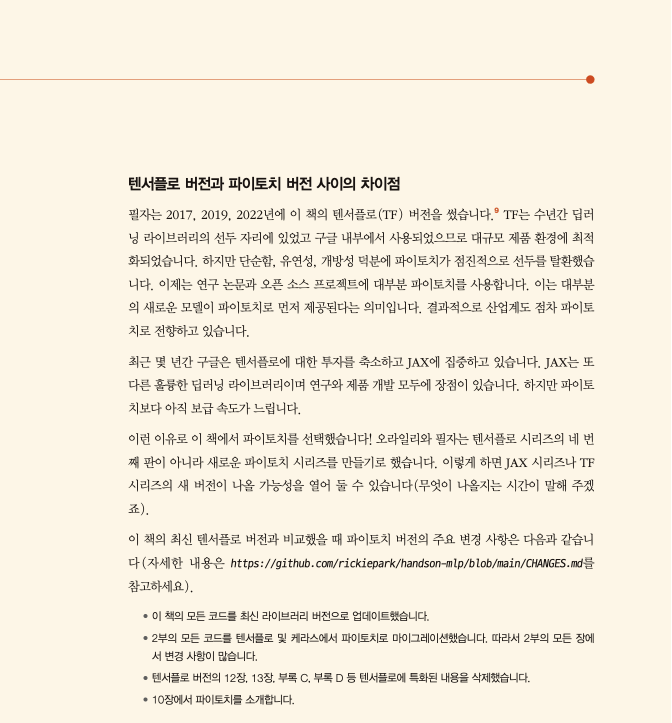
<핸즈온 머신러닝> 은 2023년에 나온 3판까지 텐서플로와 케라스로 딥러닝을 설명했습니다.
이번 책은 4판이 아니라 파이토치로 새로 시작한 별도 시리즈입니다.
저자는 머리말에서 바꾼 이유를 직접 밝힙니다.
연구 논문과 오픈 소스 대부분이 파이토치를 쓰고,
새 모델도 파이토치로 먼저 공개되니 산업계도 따라 옮겨가고 있다는 겁니다.
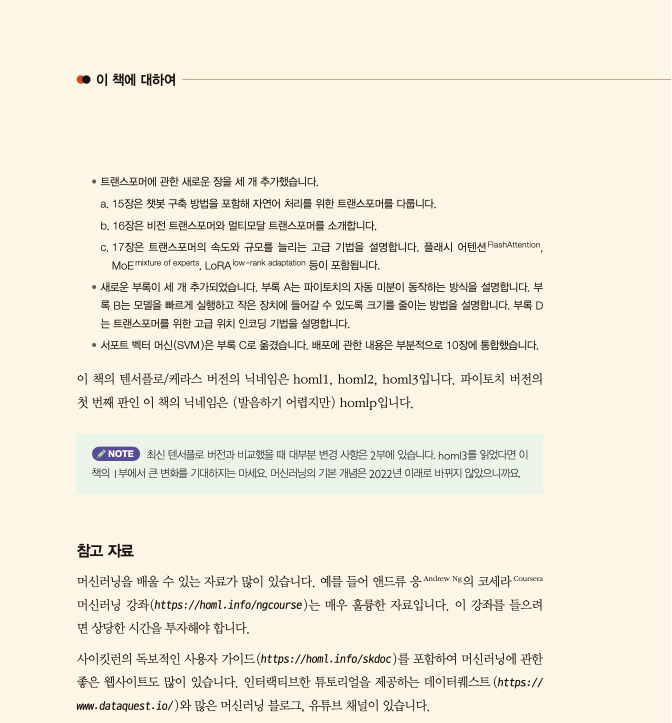
| 구분 | 핸즈온 머신러닝(3판) | 이번 책 |
|---|---|---|
| 딥러닝 실습 | 텐서플로 / 케라스 | 파이토치 |
| 트랜스포머 | 자연어 처리 장 안에서 일부 | 독립된 3개 장 (15~17장) |
| 새로 생긴 부록 | - | 자동 미분, 혼합 정밀도와 양자화, 상대 위치 인코딩 |
| 서포트 벡터 머신 | 본문 | 부록으로 이동 |
| 1부 머신러닝 기초 | 사이킷런 | 큰 변화 없음 |
3판을 읽은 분이라면 1부는 거의 그대로라고 저자가 먼저 말해 둡니다.
머신러닝 기본 개념은 2022년 이후로 바뀌지 않았다는 이유인데,
이렇게 솔직한 점이 좋은 것 같습니다.
이 책에서 건질 것 3가지
수 많은 부분들을 다 소개할 수는 없기에
개발자 입장에서 특히 읽을 만한 부분 세 장을 골랐습니다.
13장: LSTM으로 주가 예측을 해 봤다면
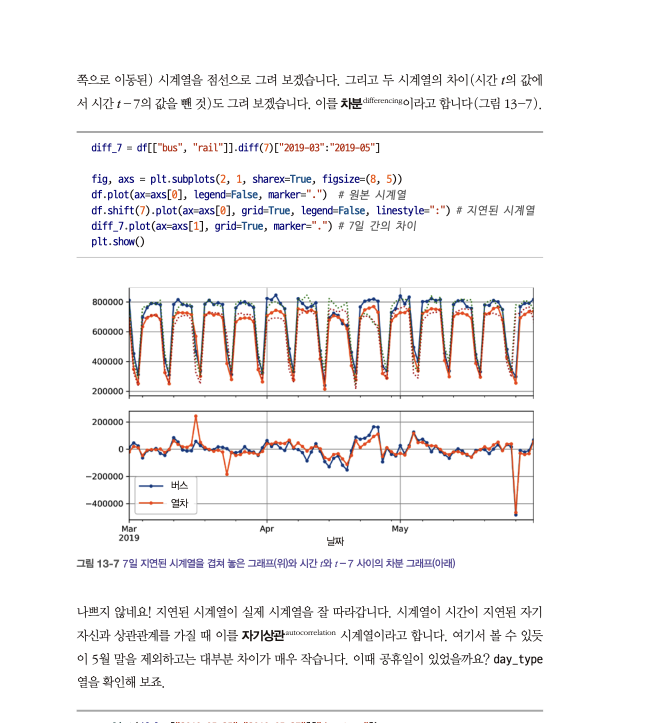
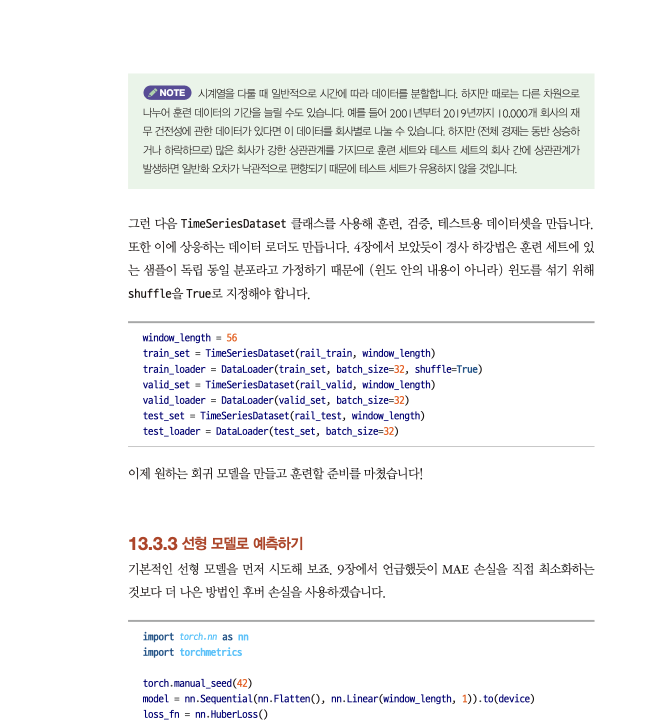
예전에 LSTM과 CNN으로 주가 예측을 간단히 해 본 적이 있습니다.
튜토리얼을 따라 하면 예측 그래프는 실제 주가와 그럴듯하게 겹쳐 나오지만,
그게 정말 잘 맞힌 건지는 따로 따져 봐야 합니다.
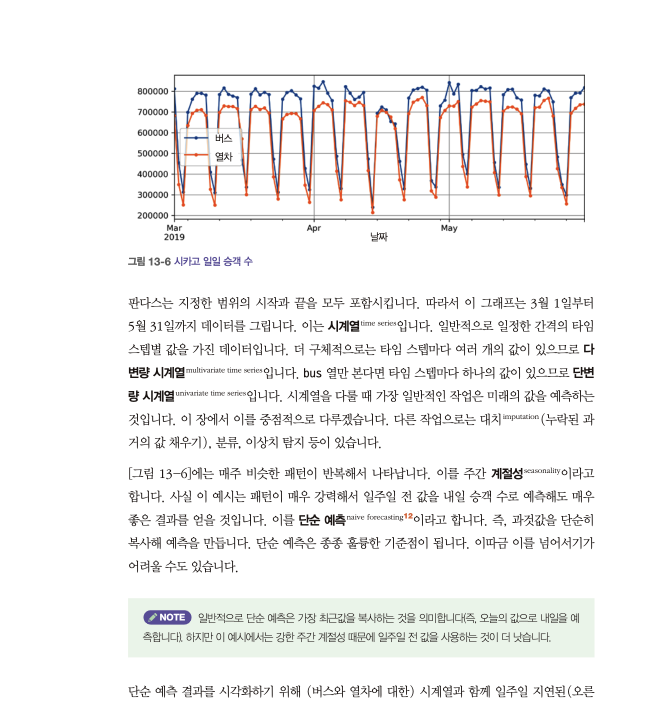
13장은 시카고 교통국에 막 입사한 데이터 과학자가 되어
내일 버스와 열차 승객 수를 예측하는 예제로 시작하는데,
RNN부터 만들지 않고 기준점부터 세웁니다.
승객 수에 주간 패턴이 뚜렷하니 일주일 전 값을 그대로
내일 값으로 쓰는 단순 예측(naive forecasting)입니다.
# 일주일 전 값으로 예측했을 때의 오차 (2019년 3~5월)
diff_7 = df[["bus", "rail"]].diff(7)["2019-03":"2019-05"]
targets = df[["bus", "rail"]]["2019-03":"2019-05"]

diff_7.abs().mean()               # MAE  → bus 43,916 / rail 42,143
(diff_7 / targets).abs().mean()   # MAPE → bus 8.3% / rail 9.0%
판다스 두 줄로 만든 이 기준점이 생각보다 강합니다.
책은 여기서 ARMA, SARIMA 같은 통계 모델을 거쳐
선형 모델, 간단한 RNN, 심층 RNN, LSTM/GRU 순서로 올라가며 같은 지표로 비교합니다.
결과도 흥미로운데, 파이토치 선형 모델은 단순 예측보다는 낫지만 SARIMA보다는 못한 것으로 나옵니다.
딥러닝이 이기는 게 당연하지 않다는 걸 숫자로 보여 주는 셈입니다.
💡 데이터 분할 함정
여러 회사의 재무 데이터를 회사별로 나눠 훈련/테스트 세트를 만들면,
경제 전체가 함께 오르내리는 탓에 회사끼리 상관관계가 생겨 테스트 점수가 낙관적으로 나옵니다. (13장 NOTE)
주가 데이터를 종목별로 나눠 검증해 봤다면 한 번쯤 뜨끔할 대목입니다.
주가 예측 모델을 만들었다면 어제 종가를 그대로 쓰는 모델보다 나은지 확인해 볼 일입니다.
15장: 20줄로 챗봇을 만들어 보기
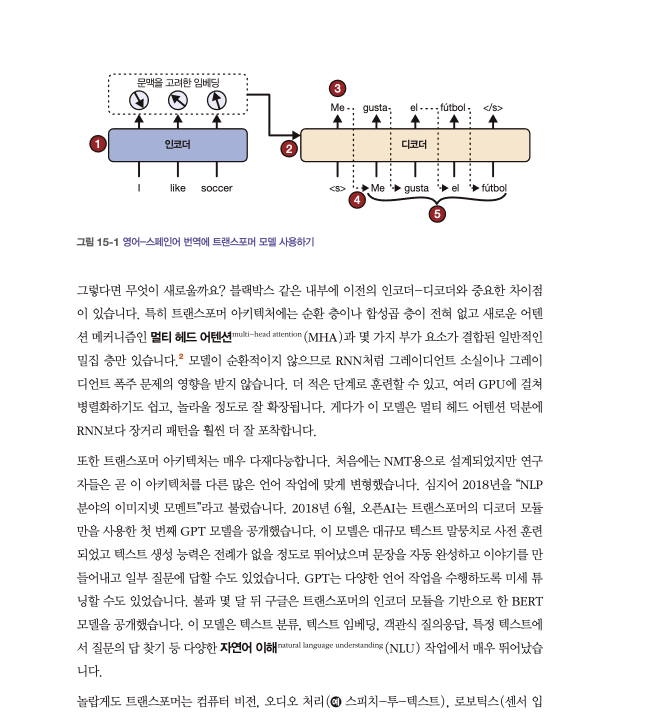
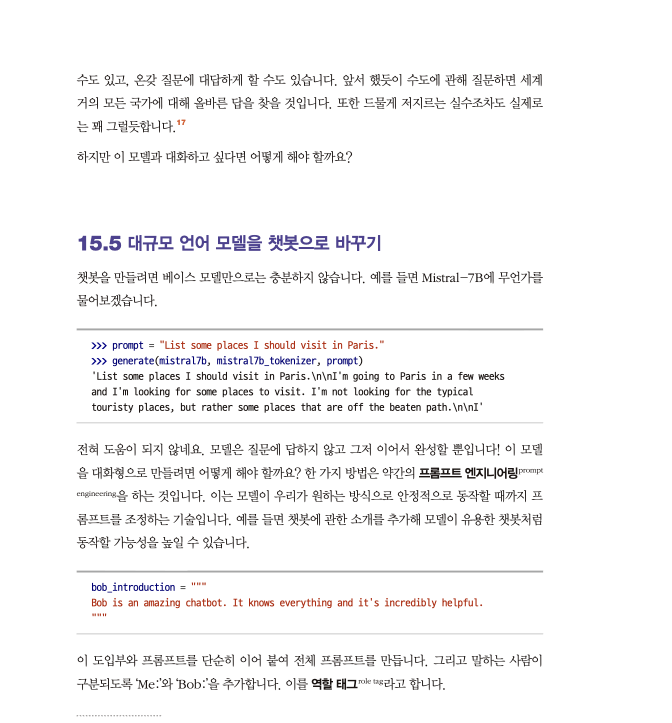
이 책에서 가장 흥미롭게 읽은 부분입니다.
15장은 트랜스포머를 밑바닥부터 구현해 번역기를 만든 뒤,
대규모 언어 모델을 챗봇으로 바꾸는 절로 넘어갑니다.
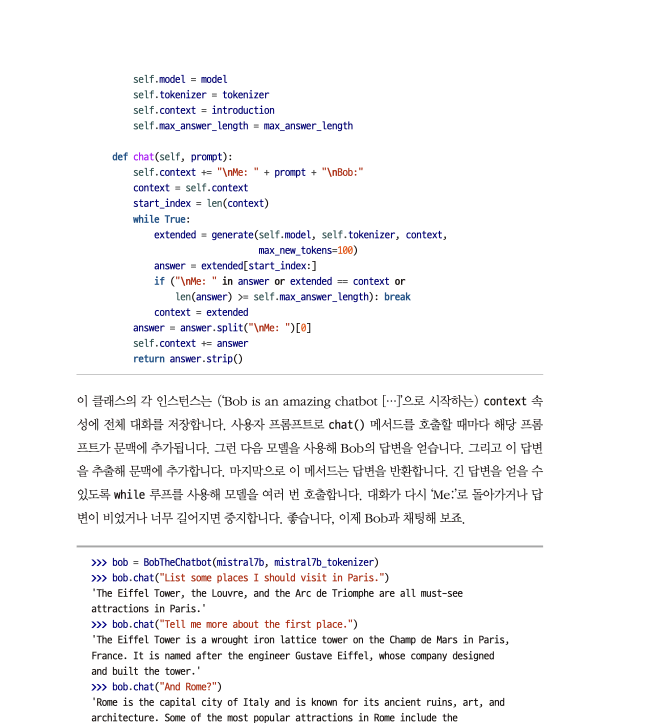
먼저 Mistral-7B 베이스 모델에 "파리에서 가 볼 만한 곳을 알려줘"라고 물어봅니다.
그런데 모델은 답하지 않고, "저도 몇 주 뒤에 파리에 가는데요..."라며 질문 글을 이어서 써 버립니다.
베이스 모델은 대화 상대가 아니라
다음 문장을 이어 쓰는 모델이라는 걸 바로 보여 주는 장면입니다.
해결책은 의외로 단순합니다.
소개 문장과 Me:, Bob: 같은 역할 태그를 붙이고, 대화를 계속 문맥에 쌓아 가면 됩니다.
class BobTheChatbot:
    def __init__(self, model, tokenizer, introduction=bob_introduction,
                 max_answer_length=10_000):
        self.model = model
        self.tokenizer = tokenizer
        self.context = introduction  # "Bob is an amazing chatbot. ..."
        self.max_answer_length = max_answer_length

    def chat(self, prompt):
        self.context += "\nMe: " + prompt + "\nBob:"
        context = self.context
        start_index = len(context)
        while True:
            extended = generate(self.model, self.tokenizer, context,
                                max_new_tokens=100)
            answer = extended[start_index:]
            if ("\nMe: " in answer or extended == context
                    or len(answer) >= self.max_answer_length):
                break
            context = extended
        answer = answer.split("\nMe: ")[0]  # 모델이 내 대사까지 지어내면 잘라냄
        self.context += answer
        return answer.strip()
bob.chat("Tell me more about the first place.")라고 물으면 앞에서 추천한 에펠탑 이야기를 이어 갑니다.
ChatGPT 같은 서비스가 대화를 어떻게 이어 가는지 코드로 감이 잡힙니다.
물론 Bob은 금방 한계를 드러냅니다.
- 농담 다섯 개를 부탁하면 같은 농담을 다섯 번 반복
- 쿠키 만드는 법을 물으면 "밀가루, 설탕, 버터, 계란을 섞으면 된다"로 끝
- 위험한 질문에도 그대로 답함
책은 이 문제를 하나씩 풀어 가며
프롬프트 체이닝, CoT, 자기 일관성, 생각의 트리(ToT), 멀티 에이전트 토론, RAG까지 소개합니다.
기법마다 원 논문 링크가 붙어 있어서 더 파고들기도 좋다고 생각합니다.
17장: KV 캐시, MoE, 플래시 어텐션을 원리부터
LLM을 서빙하거나 파인튜닝하는 분이라면
17장 "트랜스포머 가속하기"만으로도 읽을 이유가 충분합니다.
| 목적 | 다루는 기법 |
|---|---|
| 추론 가속 | KV 캐싱, 투기적 디코딩 |
| 어텐션 가속 | 희소 어텐션, 근사 어텐션, 플래시 어텐션 |
| 모델 규모 키우기 | 전문가 혼합(MoE) |
| 효율적인 훈련 | LoRA 같은 PEFT, 활성화 체크포인팅, 시퀀스 패킹, 그레이디언트 누적 |
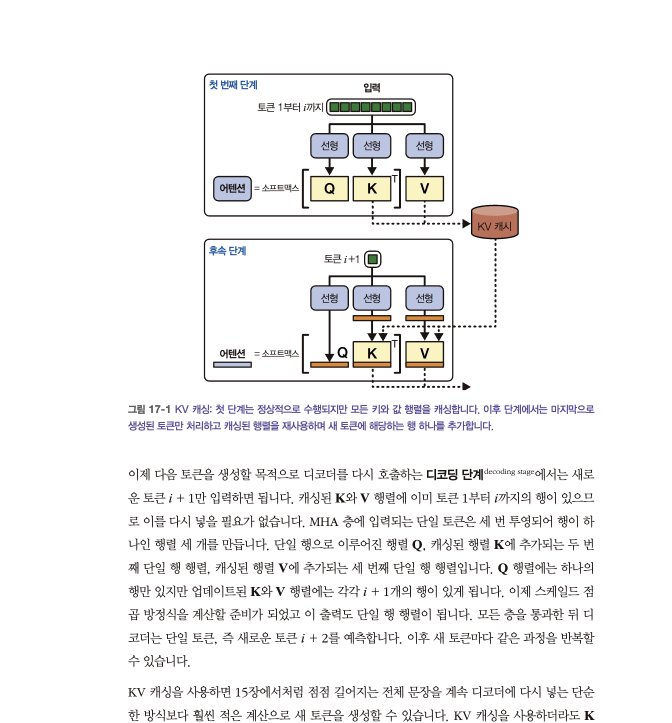
KV 캐시 설명이 특히 깔끔했습니다.
디코더에서는 미래 토큰이 과거에 영향을 주지 않으니,
새 토큰이 들어와도 K, V 행렬에 행이 하나 붙을 뿐입니다.
그래서 K와 V만 캐싱하면 되고, Q는 마지막 행만 쓰니 캐싱할 필요가 없다는 설명이 수식과 그림으로 이어집니다.
캐시를 써도 전체 생성 시간은 여전히 O(L²)이라는 점,
vLLM의 PagedAttention이 가상 메모리처럼 KV 캐시를 고정 크기 페이지에 담아 메모리 단편화를 해결한다는 내용도 나옵니다.
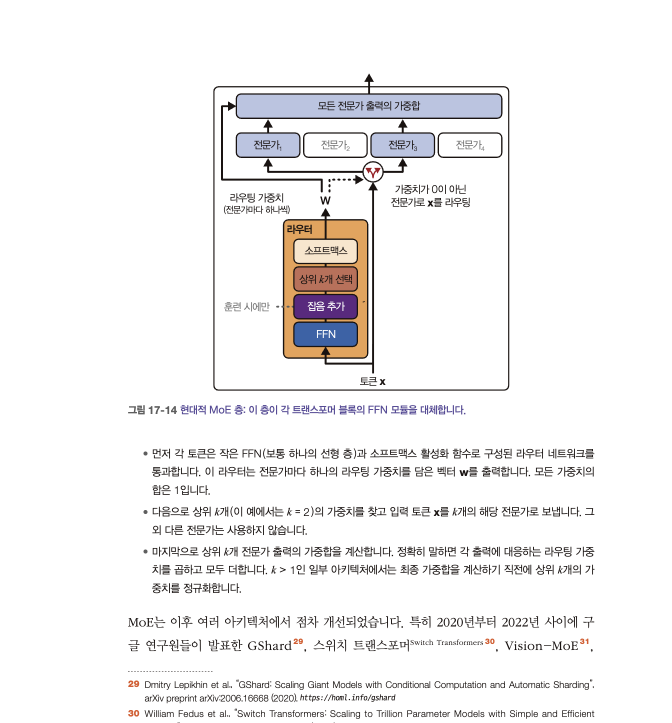
MoE 부분에서는 이름에 대한 오해를 짚어 줍니다.
전문가라고 해서 의료 질문을 의료 전문 모델이 받는 구조가 아니라,
토큰 단위로 여러 FFN에 나눠 보내는 방식이라는 겁니다.
저자는 차라리 SSSSS(sort-of specialized subnetworks splitting subtasks)라고 부르는 게 더 정확하겠지만
썩 좋은 이름은 아니라고 농담을 던집니다. 😆
원리를 설명한 뒤에는 실무에서 어떻게 켜는지도 알려 줍니다.
허깅 페이스의 generate()는 KV 캐시를 기본으로 쓰고,
플래시 어텐션은 모델을 불러올 때 옵션 하나로 켤 수 있습니다.
from transformers import AutoModelForCausalLM

# 플래시 어텐션 2로 모델 불러오기 (호환 GPU + pip install flash-attn 필요)
model = AutoModelForCausalLM.from_pretrained(
    model_id, attn_implementation="flash_attention_2"
)

# generate()는 기본으로 KV 캐시(DynamicCache)를 사용
outputs = model.generate(**inputs, max_new_tokens=100)
파이토치의 F.scaled_dot_product_attention()도 하드웨어가 맞으면 플래시 어텐션 2를 자동으로 사용합니다.
나에게 맞는 읽기 순서
머리말에 장 사이의 의존성 그림이 있어서 필요한 장만 골라 읽기 좋습니다.
그 그림을 참고해 독자 유형별로 정리해 봤습니다.

| 이런 분이라면 | 이 순서로 |
|---|---|
| 머신러닝이 처음 | 1~4장 → 6장 → 9~11장, 나머지는 필요할 때 |
| 3판을 읽은 분 | 10장(파이토치) → 15~17장(트랜스포머) |
| LLM 서빙·파인튜닝 실무자 | 15장 → 17장 → 부록 B(양자화) |
| 시계열·주가 예측에 관심 | 4장 → 10장 → 13장 |
예제는 모두 주피터 노트북으로 제공되고 구글 코랩에서 바로 실행할 수 있습니다.
정오표는 역자 블로그(tensorflow.blog/handson-mlp)에 올라오니 책을 보기 전에 확인해 두면 좋습니다.
아쉬운 점
1,100쪽이 넘는 분량이라 처음부터 끝까지 따라가기는 부담스럽습니다.
출판사는 초중급으로 소개하지만 15장 이후는 꽤 깊어서,
처음 공부하는 분이라면 위 표처럼 기초 장을 먼저 끝내고 나머지는 필요할 때 펼쳐 보길 권합니다.
(저도 아직 계속 탐독중입니다...)
마치며
저자는 머리말에서 깊은 곳으로 성급하게 뛰어들지 말라고 당부합니다.
대부분의 문제는 랜덤 포레스트 같은 간단한 기법으로 풀 수 있다는 겁니다.
(삽으로 충분한 작업에 포크레인까지 공부할 필요는 없죠)
그런데 이 책은 그 기초에서 출발해 KV 캐시와 MoE까지 실제로 데려다줍니다.
LLM을 가져다 쓰는 단계에서 한 걸음 더 들어가 보고 싶은 개발자에게 추천합니다.
한빛미디어로부터 도서를 제공받아 작성한 리뷰입니다.
'개발서 리뷰 > AI·ML 도서' 카테고리의 다른 글
| [책리뷰] 커서AI로 나만의 개발팀 만들어보기 (0) | 2026.09.29 |
|---|---|
| [책리뷰] 주니어 AI 엔지니어가 반드시 알아야 할 실무 지식 (0) | 2026.08.23 |
| [책리뷰] 하네스 엔지니어링 with 클로드 코드 (1) | 2026.06.21 |
| [책리뷰] 그림으로 풀어낸 AI 지침서, "그림으로 배우는 생성형 AI" (0) | 2026.05.23 |
| [책리뷰] 개발자가 읽은 AI 수익화 실무서 (2) | 2026.04.19 |

